Marker
将文档转换为便于处理的文本格式。
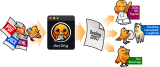
Marker 将PDF等文档转换为Markdown、JSON或HTML,处理阅读顺序、表格、公式和图片,并提供面向不同硬件的转换模式。
Marker 能做什么
它可以利用文本层、版面识别和必要的OCR,另可接语言模型改善复杂内容。不同模式并不具有完全相同的速度和识别范围。
当前代码与模型权重采用不同许可;使用托管平台或商业模型授权时,也应区分具体产品与方案。
转换结构化文档
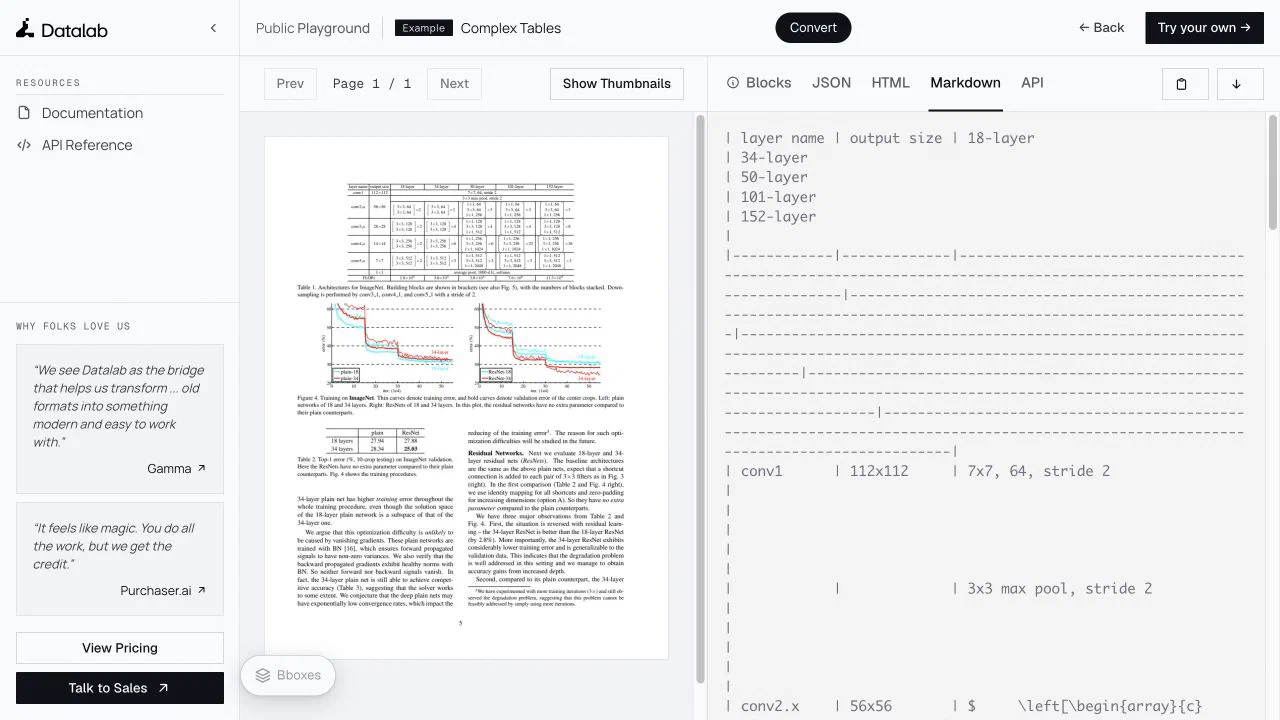
可输出Markdown、JSON和HTML,处理链接、引用、代码块、表格与公式等元素。
选择适合硬件的模式
提供balanced与fast模式:前者偏向GPU质量路径,后者减少CPU或MPS环境中的视觉模型工作量。
按需要执行OCR
会判断文本层是否可用,必要时使用OCR;disable_ocr会关闭全部视觉模型调用,包括公式处理相关调用。
用LLM改善复杂内容
可选use_llm把模型加入转换流程,用于跨页表格、表单或行内数学等复杂内容;模型端点和凭证另配。
- 核心用途
- 文档转换、表格公式处理、图片提取
- 可完成的工作
- 知识库预处理、技术文档转换和扫描资料整理
- 如何开始
- 准备Python与推理后端,先转换单个PDF
- 使用条件
- 代码与权重许可不同;复杂表单和嵌套表格仍需检查
如何使用 Marker
- 准备环境与授权
当前安装需要Python 3.10以上和PyTorch;同时查看代码与模型权重的许可条件。
- 配置推理后端
按硬件准备相应的vLLM或llama.cpp运行条件,不能只安装Python包就假定全部OCR依赖齐全。
- 先转换一个文件
使用marker_single处理代表性PDF,根据设备选择fast或balanced,非PDF输入按说明补依赖。
- 抽查再批量处理
回看表格、表单和公式,必要时使用LLM或OCR选项,再将合格设置用于后续文件。
转换技术PDF为知识库输入
适合:维护文档检索的人
- 准备输入
- 技术PDF、目标导出格式及关键页面。
- 操作方法
- 编辑建议:先转换一份代表文件,对照标题、公式和代码块,再将通过的文本交给下游检索。
- 预期交付物
- 可继续分块的结构化文档。
- 人工检查
- 检查代码缩进、公式和跨栏顺序,不只看输出文件存在。
整理扫描资料
适合:需要OCR的档案处理者
- 准备输入
- 扫描PDF及可用推理后端。
- 操作方法
- 编辑建议:选择适合硬件的模式,处理少量扫描页,必要时调整OCR设置后继续。
- 预期交付物
- 可搜索的扫描文本。
- 人工检查
- 核对漏字、页码和旋转页面;记录无法稳定识别的页。
提取跨页表格
适合:需要处理报告表格的人
- 准备输入
- 跨页表格样本及重要数值。
- 操作方法
- 编辑建议:先查看基础转换,必要时启用LLM辅助,再逐格比对表头和单位。
- 预期交付物
- 表格重建候选。
- 人工检查
- 合并和补全可能出错,关键数值必须与原PDF一致。
界面与参考图片
开始前需要了解
权重商业条件另行适用
当前代码为Apache 2.0,模型权重采用修改版AI Pubs OpenRAIL-M;研究、个人及符合规模条件的创业公司与其他商业使用适用条件不同。
复杂版式可能转换不佳
官方列出嵌套表格、复杂布局和表单等限制;LLM或强制OCR可作为改善选项,但仍须检查结果。
额外模式有额外依赖
非PDF需full依赖,OCR涉及推理后端,use_llm还需模型服务;不要把纯文本层提取的资源需求套用到全部模式。
代码与模型权重许可不同;商业权重使用需按规模和条款确认,OCR另需相应推理后端。
账号权限、费用与可用功能请以官方入口的当前说明为准。重要结果应先检查,再用于实际工作。
常见问题
Marker可以直接免费商用吗?
需分别查看代码与权重条件。代码采用Apache 2.0,但权重有独立商业门槛,不能用代码许可替代权重授权。
CPU电脑应该怎样开始?
先按官方说明准备CPU可用后端,并从fast模式和单份文档开始检查资源与输出。
关闭OCR有什么影响?
disable_ocr会关闭视觉模型调用,包括公式等相关处理,只走文本层提取;扫描内容可能因此无法完整处理。
处理非PDF文件需要什么?
官方要求安装marker-pdf的full附加依赖,同时确认目标格式与实际文件能被正确解析。