RAGFlow
提供 RAG 引擎与智能体编排能力的 AI 上下文和知识平台。
RAGFlow 是结合文档理解与智能体能力的开源 RAG 引擎,提供资料解析、可视化分块、引用追溯和多步检索,可选择云服务或自行部署。
RAGFlow 能做什么
它更关注模型回答前的上下文准备:复杂文档被解析成可查看的片段,再通过检索和重排序提供给模型。
适合拥有大量PDF、表格或混合文档的团队。先检查解析结果,再评估答案;仅看到流畅回答不足以判断知识库是否可用。
对照原文检查知识片段
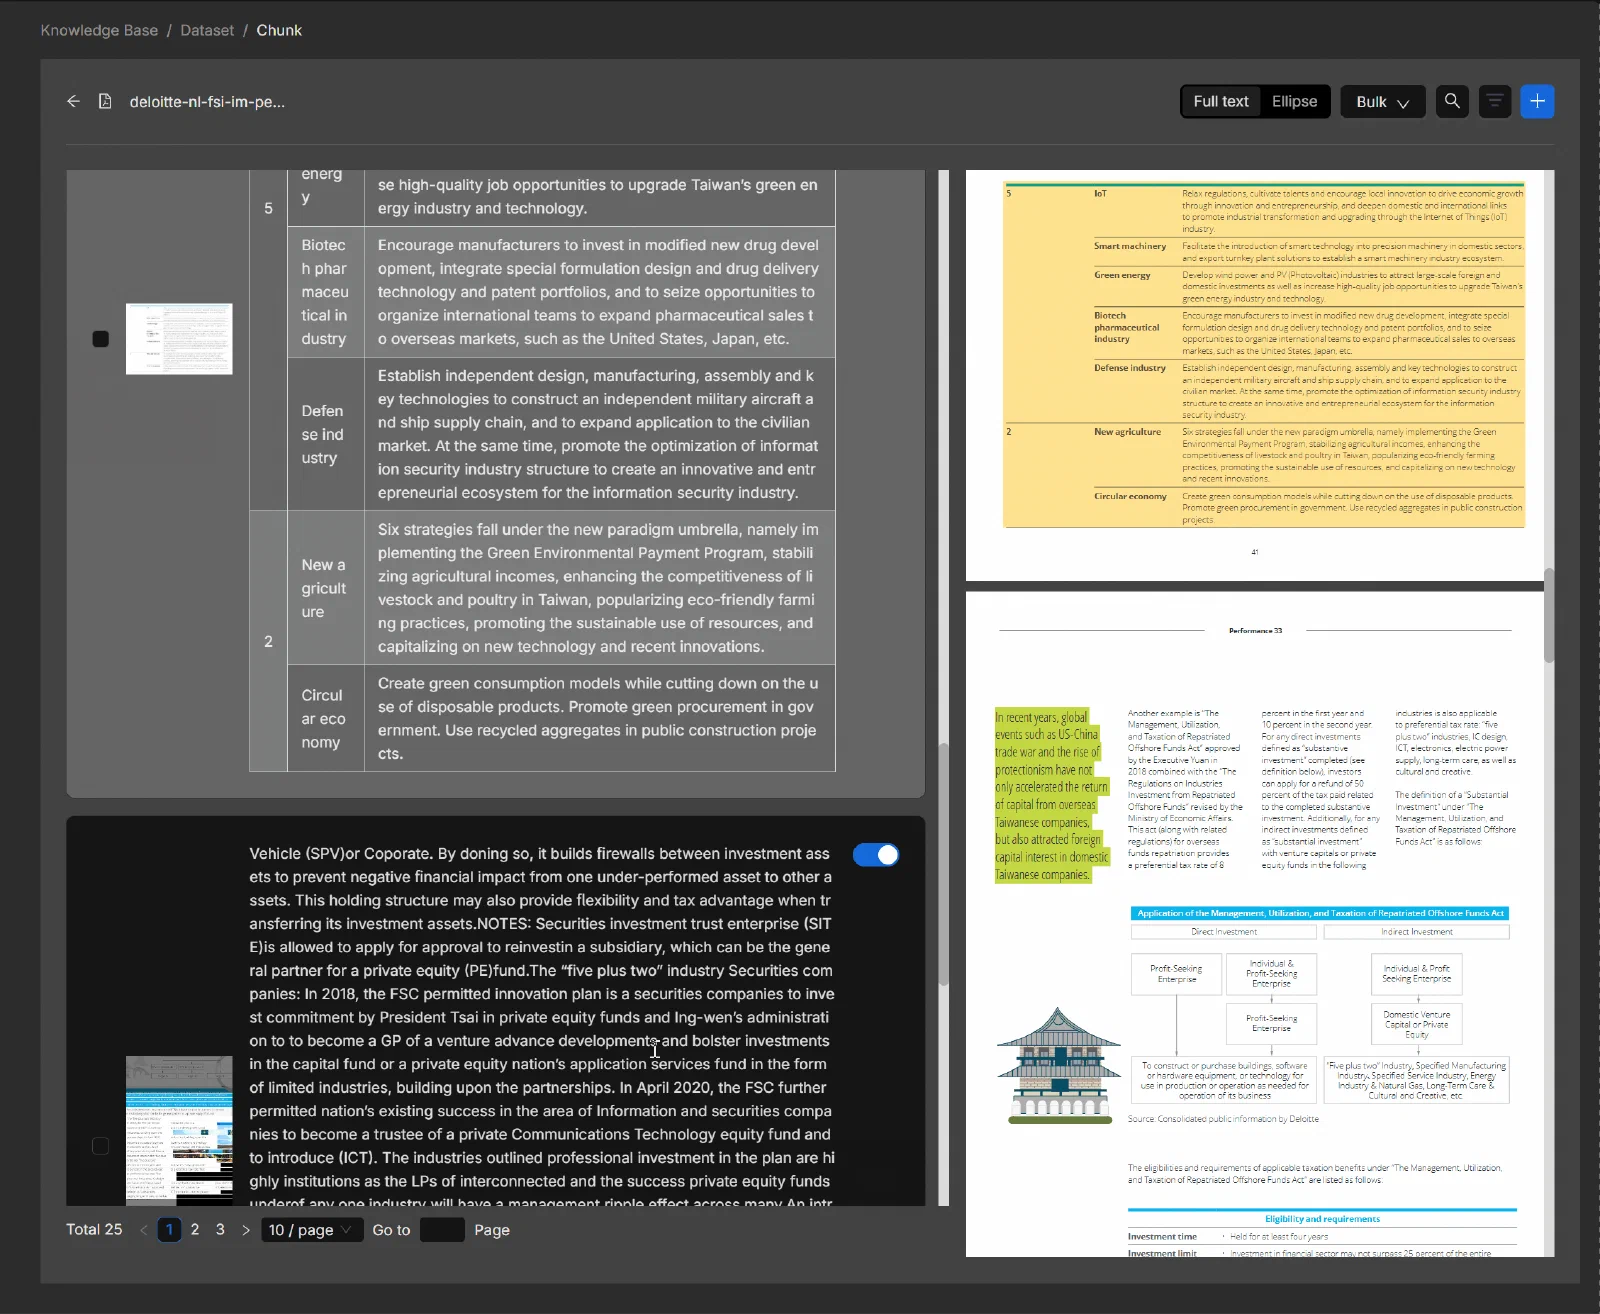
支持基于模板的分块与可视化查看,用户可以对照PDF等原文干预解析结果,使表格、段落和引用保持可追溯。
接收多种业务资料
支持Word、演示文稿、表格、图片、扫描件、PDF和网页等资料,将异构内容放入统一知识处理流程。不同资料仍需选择合适的处理方式。
对复杂问题进行多轮检索
Agentic Retrieval可分析和分解问题,再多次检索与核对依据;不同思考深度用于平衡问题复杂度和处理成本。
把资料编译成结构化知识
Knowledge Compilation可在文档或数据集层面生成Wiki、图谱、树、思维导图等知识产物,并支持更新或重新生成。
- 核心用途
- 复杂文档解析、可视分块、引用与智能检索。
- 可完成的工作
- 手册查询、研究资料整理和业务知识问答。
- 如何开始
- 从官方云服务开始,或按版本文档部署Docker环境。
- 使用条件
- 本地部署需算力、存储与模型配置,资源随资料量增长。
如何使用 RAGFlow
- 选择云端或本地环境
从官方云服务体验,或按目标版本的Docker部署文档准备依赖。
- 配置模型和资料集
选择语言模型与嵌入模型,导入小批代表性资料。
- 审查分块与检索
对照原文检查表格和段落,再用标准问题观察引用和召回结果。
- 扩展工作流
需要时调整检索深度或知识编译模板,通过API接入业务并保留回归问题集。
查询跨章节设备说明
适合:技术支持人员
- 准备输入
- 带目录、表格和适用型号的PDF手册
- 操作方法
- 编辑建议:选择解析方式,抽查关键页分块,再提问需要跨章节才能回答的问题。
- 预期交付物
- 带引用的技术答复
- 人工检查
- 逐项核对型号、参数单位及引用原文。
整理多份研究材料
适合:研究助理
- 准备输入
- 同一主题的论文或报告
- 操作方法
- 编辑建议:按主题建立数据集,用知识编译形成结构,再通过多轮检索追问不同资料的分歧。
- 预期交付物
- 主题结构和证据对照
- 人工检查
- 区分资料原话与模型归纳,不合并不兼容的统计口径。
为业务应用提供检索上下文
适合:应用开发者
- 准备输入
- 知识库、固定问题集和输出格式
- 操作方法
- 编辑建议:先在界面验证检索,再通过API连接测试应用;保留引用供用户查看。
- 预期交付物
- 能回溯资料的问答功能
- 人工检查
- 检查空检索、权限隔离及资料更新后的答案。
界面与参考图片
开始前需要了解
本地运行需要实际资源
官方给出CPU、内存和磁盘的起始建议,但实际需求取决于文档引擎、资料量、解析并发及本地模型。不能只按安装包大小估算成本。
解析正确性必须单独验收
多格式支持不保证扫描质量和表格结构都能正确提取。应利用分块可视化检查关键内容,错误片段会直接影响引用。
不同版本部署方式会变化
Docker和源码启动面向不同用途。请选择明确版本并遵循对应依赖、迁移和健康检查说明,升级前保留数据备份。
云服务或自部署分别选择,复杂文档需检查分块和引用,本地资源需求随资料与并发增长。
账号权限、费用与可用功能请以官方入口的当前说明为准。重要结果应先检查,再用于实际工作。
常见问题
扫描PDF也能用吗?
支持扫描件和PDF等输入,但需要检查识别文字、表格及分块边界,低质量扫描不会自动变成可靠知识。
可以查看回答依据吗?
可以。RAGFlow提供引用追溯和片段查看,用于把回答与知识库原文对应。
必须自己搭服务器吗?
不必,官方提供云服务入口;自部署则需要维护依赖、存储和模型配置。
复杂问题只能检索一次吗?
不是。Agentic Retrieval可以进行多轮检索与推理,并按问题需要选择思考深度。